Tôi nhớ lần đầu vào một nhóm chat về AI, có người viết “context window của con này chỉ 128k nên phải cắt bớt”, người khác đáp “thế thì dùng RAG chứ đừng nhồi hết vào prompt”. Tôi đọc ba lượt vẫn không hiểu họ đang nói về cái gì, dù từng chữ đều quen thuộc, và cảm giác ấy khó chịu hơn nhiều so với đọc một bài tiếng Anh chuyên ngành xa lạ.
Bài này tôi viết cho đúng trạng thái đó: bạn chưa biết gì hoặc biết lơ mơ, và muốn có một đường đi từ đầu đến cuối thay vì mỗi lần gặp một từ lạ lại phải mở Google tra riêng. Tôi sẽ đi theo ba tầng mà một hệ AI thực sự có, vì hiểu ba tầng ấy thì phần lớn thuật ngữ tự rơi vào đúng chỗ.
Ba tầng của một hệ AI đang làm việc
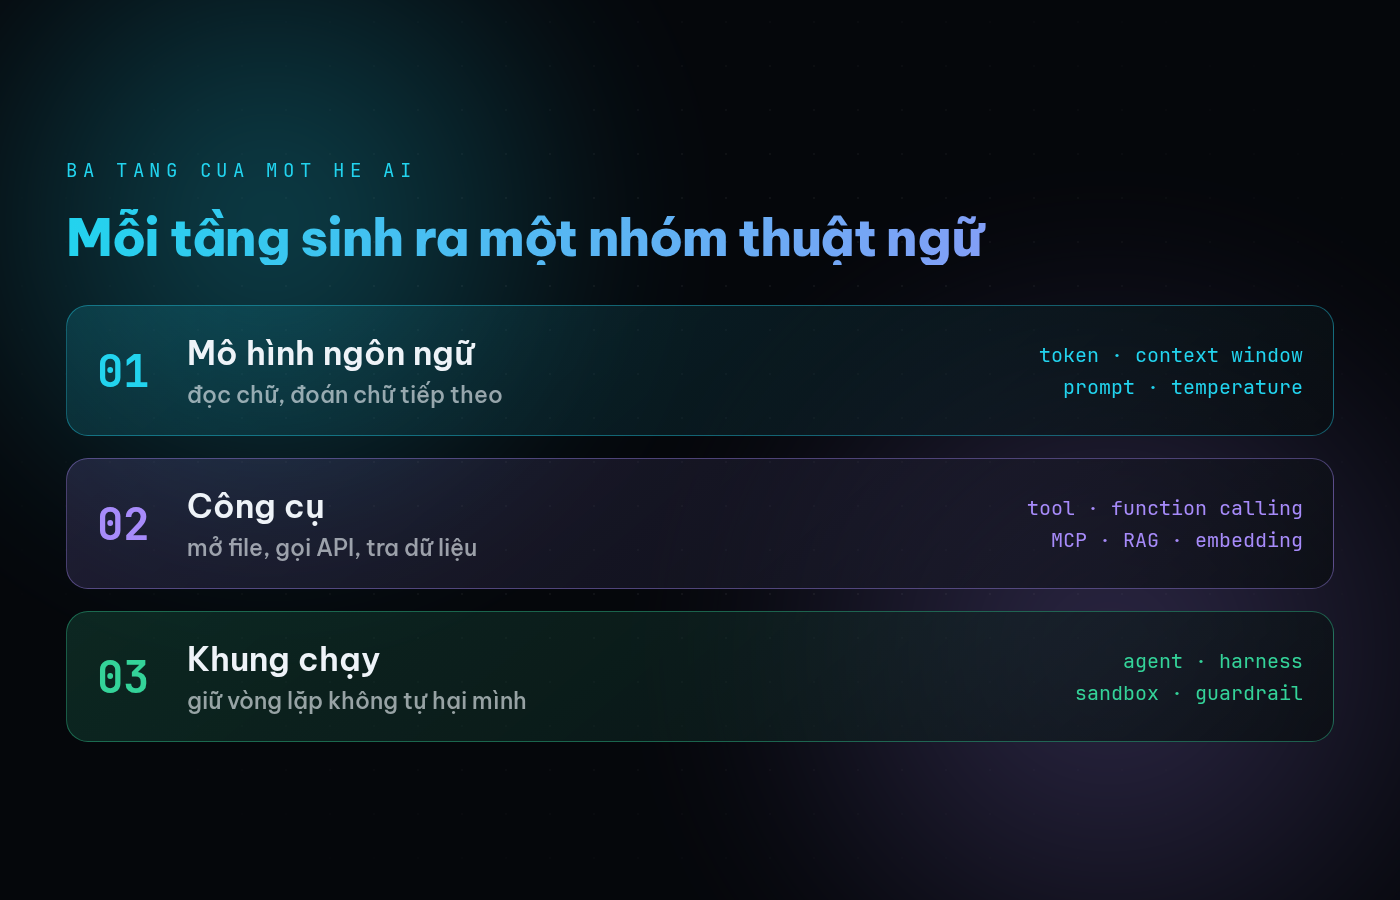
Khi bạn chat với ChatGPT hay Claude trên trình duyệt, bạn chỉ thấy một ô nhập và một ô trả lời. Nhưng phía sau có ba lớp xếp lên nhau, và mỗi lớp sinh ra một nhóm thuật ngữ riêng nghe rất giống nhau.
Lớp thứ nhất là bộ máy sinh chữ, hay còn gọi là mô hình ngôn ngữ, và nó chỉ biết đúng một việc là đọc một đoạn chữ rồi đoán xem chữ tiếp theo nên là gì. Lớp này sinh ra token, context window, prompt, temperature và hallucination.
Lớp thứ hai là cách cho bộ máy đó dùng được công cụ bên ngoài, thay vì chỉ trả lời bằng ký ức đã học thì cho nó mở file, gọi API, tìm trong cơ sở dữ liệu của bạn. Lớp này sinh ra tool, function calling, MCP, RAG và embedding.
Lớp thứ ba là khung quản lý lớp thứ hai, thứ giữ cho nó chạy đúng vòng, không lặp vô hạn, không xoá nhầm dữ liệu và không tiêu hết hạn mức mà không ai biết. Lớp này sinh ra agent, harness, sandbox, subagent và guardrail, tức nhóm khó nhất vì nó nói về cách vận hành chứ không nói về năng lực.
Tầng một: mô hình ngôn ngữ và những từ bạn gặp đầu tiên
Từ đầu tiên ai cũng gặp là LLM
, viết tắt của Large Language Model, tiếng Việt gọi là mô hình ngôn ngữ lớn. Bản chất của nó đơn giản hơn cái tên nhiều: nó là chương trình đã đọc một lượng chữ khổng lồ rồi học cách đoán chữ tiếp theo, nên khi bạn gõ câu hỏi thì nó lần lượt đoán từng chữ của câu trả lời cho tới khi xong.
Token
là đơn vị chữ mà mô hình thật sự đọc và ghi, không theo từ như bạn và cũng không theo ký tự, mà theo mảnh chữ có sẵn trong bộ từ vựng của nó. Với tiếng Anh thì một token thường là khoảng bốn ký tự, còn với tiếng Việt thì tốn hơn vì dấu và các cụm như “nắp hố ga” bị cắt thành nhiều mảnh. Đây chính là lý do người ta nói tiếng Việt tốn token hơn tiếng Anh khoảng một lần rưỡi đến hai lần.
Context window
là số token tối đa mô hình giữ được trong một lượt làm việc, và cách dễ hình dung nhất là chiếc bàn làm việc: bàn càng lớn thì bày được nhiều giấy tờ cùng lúc, nhưng khi giấy vượt mặt bàn thì bạn buộc phải cất bớt tài liệu và tài liệu bị cất thì mô hình không còn nhìn thấy. Các mô hình lớn hiện nay có context window từ vài chục nghìn đến vài triệu token, nhưng bàn lớn không có nghĩa là mô hình dùng giỏi phần cuối bàn.
Prompt
là phần chữ bạn đưa vào, gồm cả câu hỏi và mọi thứ kèm theo như tài liệu, ví dụ mẫu hay chỉ dẫn. Người ta hay phân biệt system prompt là phần chỉ dẫn nền do người làm sản phẩm đặt sẵn với user prompt là phần bạn tự gõ, nhưng thực tế hai phần này nối thành một chuỗi duy nhất mà mô hình đọc. Đó là lý do đôi khi bạn thấy nó quên yêu cầu của bạn sau khi đọc một file dài, vì phần của bạn đã bị cắt mất khi bàn hết chỗ.
Inference là từ chỉ quá trình mô hình sinh ra câu trả lời, nên khi ai đó nói inference tốn GPU thì họ đang nói tới việc chạy mô hình để lấy kết quả, khác hoàn toàn với quá trình huấn luyện đã xảy ra từ trước. Một số dịch vụ tính tiền theo số token đầu vào và đầu ra, nên chi phí phụ thuộc trực tiếp vào độ dài hai phần ấy.
Temperature là nút chỉnh độ ngẫu nhiên. Ở mức thấp thì mô hình chọn phương án có xác suất cao nhất và trả lời ổn định. Còn ở mức cao thì nó chấp nhận cả phương án ít khả năng hơn nên câu trả lời đa dạng nhưng dễ lan man. Với việc cần số liệu chính xác thì hãy để thấp, còn với việc cần ý tưởng thì hãy nâng lên.
Hallucination
là khi mô hình trả lời trôi chảy nhưng sai sự thật, thường là bịa số liệu, bịa tên tài liệu hoặc bịa đường dẫn. Đây là hệ quả trực tiếp của cách nó hoạt động, vì nó được huấn luyện để đoán chữ nghe hợp lý chứ không tra cứu sự thật. Hiểu điều này thì bạn sẽ tự kiểm lại những chỗ quan trọng thay vì tin hoàn toàn.
Tầng hai: agent, khi mô hình biết dùng công cụ
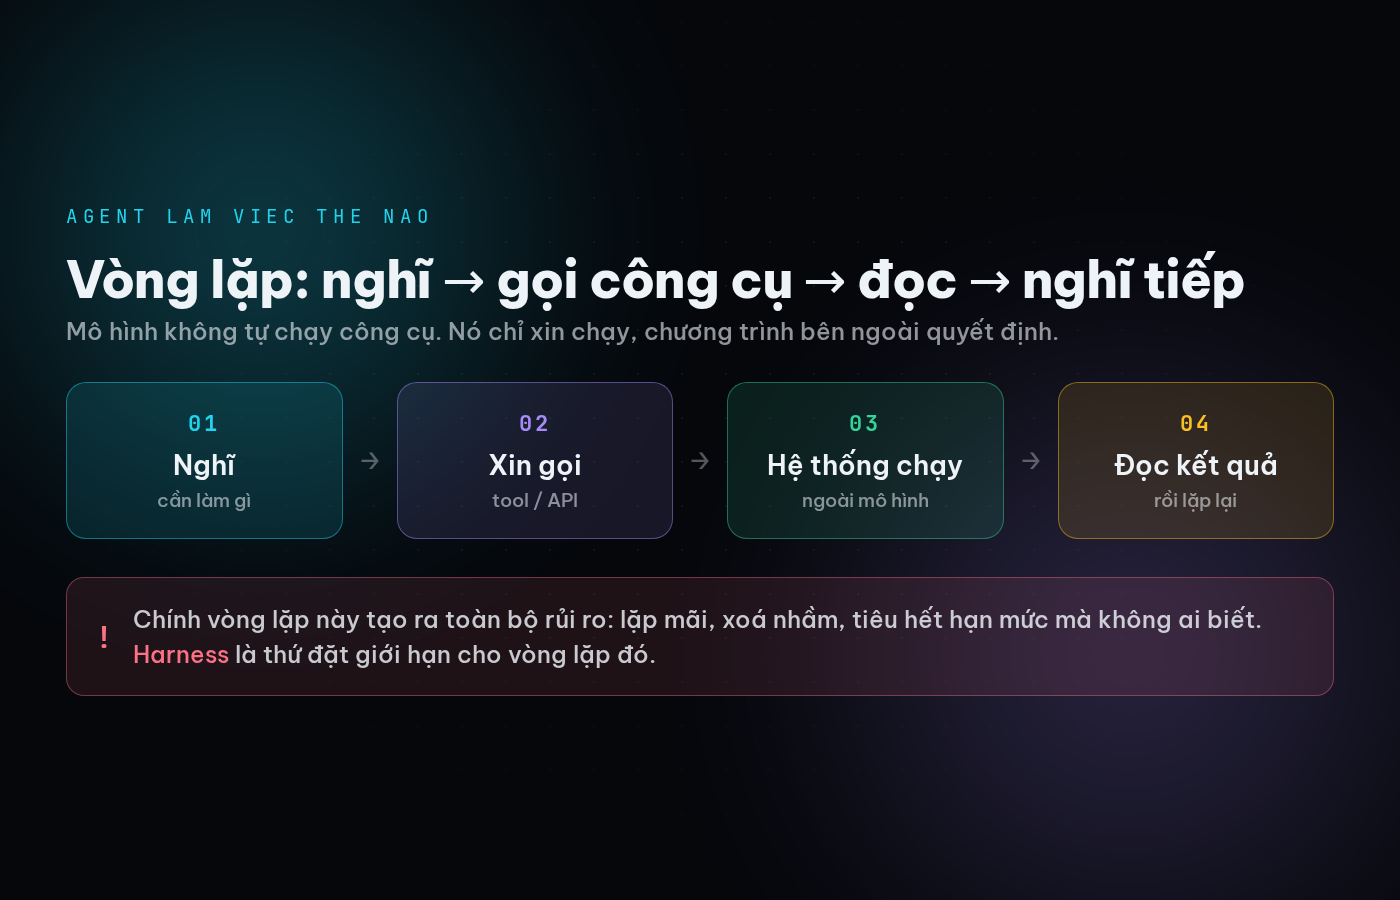
Một mình mô hình ngôn ngữ chỉ trả lời được bằng những gì nó đã đọc, nó không mở được file của bạn, không xem được trang web hôm nay và không ghi được dữ liệu vào hệ thống nào. Tool
là cách vá lỗ hổng đó: bạn khai báo cho mô hình danh sách việc nó được phép nhờ hệ thống làm kèm mô tả từng việc, rồi khi cần thì mô hình trả về yêu cầu gọi đúng việc ấy và hệ thống của bạn thực hiện rồi đưa kết quả lại cho nó đọc tiếp.
Cơ chế này có tên là function calling, và hệ quả quan trọng cần nhớ là mô hình không tự chạy công cụ mà chỉ xin chạy, còn chương trình bên ngoài mới quyết định có cho chạy hay không. Mọi cơ chế an toàn về sau đều dựa trên điểm này.
MCP
, viết tắt của Model Context Protocol, là chuẩn chung để khai báo công cụ cho mô hình, do Anthropic công bố và nhiều bên dùng theo. Trước khi có nó thì mỗi ứng dụng tự định nghĩa cách nối riêng nên cùng một công cụ muốn dùng ở hai ứng dụng phải viết hai lần. Còn có MCP thì bạn viết một lần rồi cắm vào nhiều nơi như ổ cắm điện tiêu chuẩn.
Embedding là cách biến một đoạn chữ thành một dãy số sao cho hai đoạn chữ có nghĩa gần nhau thì hai dãy số cũng gần nhau, nhờ vậy máy tính tìm được đoạn văn liên quan mà không cần trùng từ khoá. Khi bạn hỏi về cách chống mùi hôi hố ga và hệ thống tìm ra một đoạn viết về gioăng cao su kín khít thì đó là embedding đang làm việc.
RAG
là viết tắt của Retrieval-Augmented Generation, nghĩa là tìm tài liệu trước rồi mới sinh câu trả lời, thay vì nhồi toàn bộ tài liệu vào bàn làm việc và hy vọng mô hình nhớ hết. Hệ thống chia tài liệu thành từng mảnh, biến mỗi mảnh thành embedding, cất vào kho gọi là vector database, rồi khi có câu hỏi thì tìm những mảnh gần nghĩa nhất và đưa đúng những mảnh ấy cho mô hình đọc. Cách này vừa tiết kiệm token vừa giảm bịa vì mô hình trả lời trên tài liệu thật.
Tầng ba: harness, thứ giữ cho agent không tự bắn vào chân
Agent
là khi bạn ghép mô hình ngôn ngữ với một vòng lặp và một bộ công cụ, và thay vì trả lời một lần rồi dừng thì agent làm theo chu trình nghĩ xem cần làm gì, gọi công cụ, đọc kết quả, nghĩ tiếp rồi lặp cho tới khi xong việc. Chính vòng lặp này tạo ra khác biệt lớn về năng lực nhưng cũng tạo ra toàn bộ rủi ro mới, vì nó có thể lặp mãi, xoá nhầm hoặc tiêu hết hạn mức mà không ai biết.
Harness
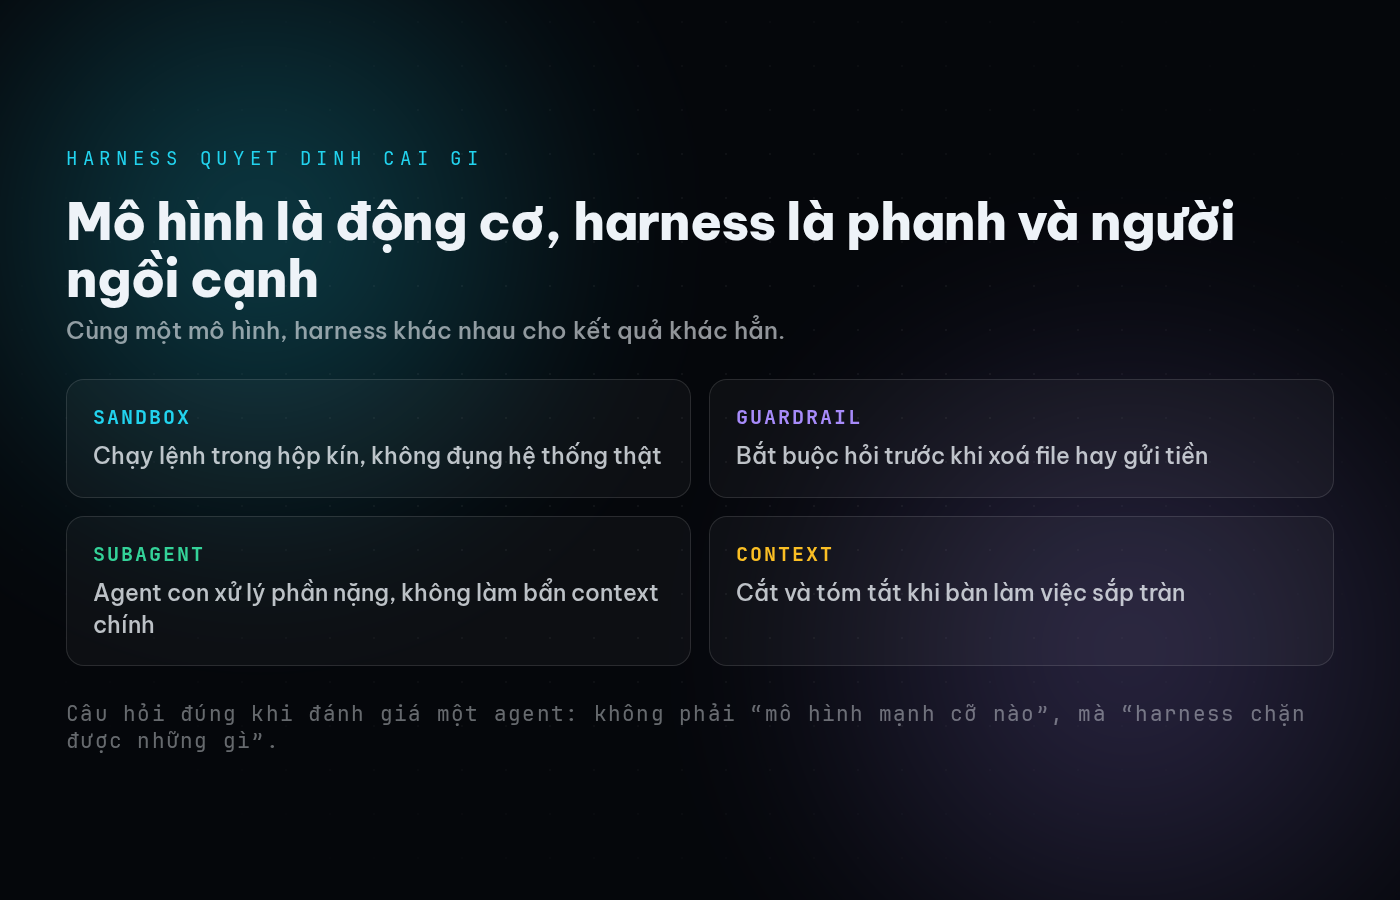
là phần khung bao quanh agent để quản lý những rủi ro đó, và từ này chưa có cách dịch thống nhất sang tiếng Việt nên có người gọi là khung chạy còn có người giữ nguyên tiếng Anh. Nội dung thì rõ ràng: harness quyết định agent được dùng công cụ nào, đọc thư mục nào, chạy bao nhiêu bước một lượt, khi nào phải dừng hỏi người. Và cắt context theo cách nào để không tràn bàn làm việc.
Nói cách khác thì mô hình là động cơ, agent là chiếc xe, còn harness là toàn bộ hệ thống lái, phanh và người ngồi cạnh can thiệp khi cần. Một chiếc xe không có phanh thì chạy được nhưng không ai dám cho lên đường, và đây là lý do khi đánh giá một công cụ agent thì câu hỏi đúng không phải là mô hình mạnh cỡ nào mà là harness chặn được những gì.
Trong harness có mấy khái niệm bạn sẽ gặp thường xuyên. Sandbox là môi trường cách ly để agent chạy lệnh trong hộp kín mà không đụng được vào hệ thống thật. Guardrail là rào chắn mềm đặt trước những hành động nguy hiểm như bắt buộc hỏi trước khi xoá file. Subagent là agent con do agent chính giao việc để xử lý một phần nặng mà không làm bẩn bàn làm việc của agent chính.
Có một chi tiết ít người mới để ý là phần lớn chất lượng của một hệ agent không nằm ở mô hình mà nằm ở harness. Cùng một mô hình đặt trong harness biết cắt context đúng lúc sẽ cho kết quả khác hẳn harness chỉ nối thêm tin nhắn vào cuối. Nếu thử hai công cụ cùng mô hình mà thấy chênh rõ rệt thì phần chênh đó gần như luôn là harness, và đây cũng là điều tôi rút ra khi so sánh nhiều công cụ trong bài đo 14 repo kỹ năng cho Claude.
Thứ tự học, và ba câu người mới hay hỏi tôi nhất
Nếu bạn mới bắt đầu thì tôi khuyên đi đúng thứ tự ba tầng trên chứ đừng nhảy cóc, và học tầng một cho chắc vì hiểu token, context window, temperature là đủ để bạn biết vì sao cùng một câu hỏi mà hôm nay trả lời hay hôm qua trả lời dở. Ba từ này giải thích phần lớn hiện tượng khó chịu mà người mới hay đổ lỗi cho AI ngu.
Rồi học tầng hai qua một việc cụ thể: lấy một việc bạn làm hằng ngày như tra cứu giá sản phẩm trong Excel rồi tự hỏi cần bao nhiêu bước để máy làm hộ, và khi tự vẽ ra được các bước thì thuật ngữ sẽ khớp vào đúng chỗ. Tầng ba nên học sau cùng và nên học bằng cách đọc tài liệu của một harness cụ thể, vì đó là nơi các quyết định thiết kế khác nhau rõ nhất giữa các sản phẩm, còn đọc lý thuyết chung dễ ra một mớ từ trừu tượng.
Câu hỏi: có cần học lập trình mới dùng được agent không? Trả lời: không cần để dùng, nhưng cần hiểu sơ để đánh giá, vì phần lớn rủi ro nằm ở việc agent được cấp quyền gì chứ không nằm ở code. Bạn có thể xem bốn kỹ năng agent đáng lấy từ một repo 37 sao để thấy mức can thiệp cần tới đâu.
Câu hỏi: nên chọn mô hình nào cho người mới? Trả lời: mô hình nào cũng đủ, chọn theo giá và tốc độ, rồi sau hai tuần dùng thật bạn sẽ tự biết mình cần mô hình mạnh hơn cho việc gì. Việc đổi mô hình giữa các nhà cung cấp hiện nay khá dễ nên đừng mất thời gian chọn trước khi dùng.
Câu hỏi: harness có phải là phần mềm riêng phải cài thêm không? Trả lời: không hẳn, harness có thể là sản phẩm đóng gói sẵn như Hermes hay Claude Code, cũng có thể chỉ là đoạn script vài chục dòng bạn tự viết để giới hạn số bước và danh sách công cụ. Quan trọng là biết hệ thống mình đang chặn gì.
Bạn đang kẹt ở tầng nào, và thuật ngữ nào đọc hoài vẫn không hình dung ra? Hãy để lại bình luận bên dưới, càng cụ thể càng tốt — ví dụ bạn đang thử dựng một agent nhỏ mà không hiểu vì sao nó lặp mãi. Tôi đọc hết bình luận và sẽ viết bài riêng cho những thuật ngữ được hỏi nhiều nhất, kèm ví dụ thật.
Quét mã QR để đọc bài viết này để xem tiếp trên điện thoại